Pourquoi choisir un serveur dédié pour vos projets IA ?
- Des ressources réservées pour des calculs exigeants
- Une architecture adaptée à chaque usage IA
- Un meilleur contrôle sur les logiciels et les données
- Des performances plus prévisibles pour les utilisateurs
- Une sécurité mieux adaptée aux projets sensibles
- Quand le serveur dédié devient particulièrement pertinent ?
- Préparer le déploiement avec une méthode simple
- Questions fréquentes
Un serveur dédié offre à un projet d'intelligence artificielle des ressources réservées, une configuration maîtrisée et une meilleure prévisibilité des performances. Pour entraîner un modèle, servir une API de génération ou traiter des lots de données sensibles, cette stabilité évite les ralentissements liés au partage de machine et donne davantage de contrôle sur l'infrastructure.
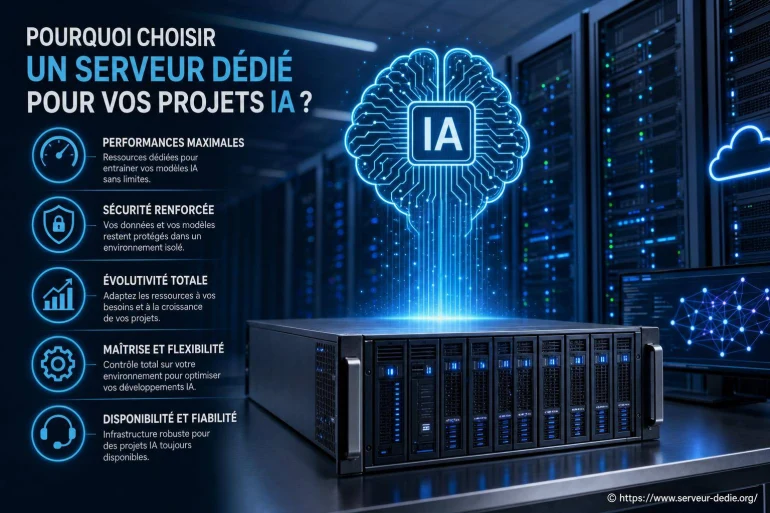
Pourquoi choisir un serveur dédié pour vos projets IA ? Parce que les charges de travail IA demandent souvent beaucoup de calcul, de mémoire vive, d'espace de stockage rapide et parfois un accès direct à des GPU. Une machine exclusivement attribuée à votre activité rend ces éléments plus simples à dimensionner, à surveiller et à faire évoluer.
Des ressources réservées pour des calculs exigeants
Les applications d'IA ne sollicitent pas un serveur de façon régulière. L'entraînement d'un modèle peut mobiliser tous les cœurs CPU pendant plusieurs heures, tandis qu'une phase d'inférence peut réclamer beaucoup de mémoire ou de puissance GPU en quelques secondes. Sur un environnement mutualisé, les performances peuvent varier selon l'activité des autres clients. Avec un serveur dédié, le processeur, la RAM, les disques et la bande passante restent disponibles pour votre projet.
Cette différence est concrète lors du traitement d'images, de transcriptions audio, de recherches sémantiques ou de classification de documents. Si un modèle doit analyser plusieurs milliers de fichiers, une machine dont les ressources sont entièrement réservées réduit les files d'attente et rend les délais plus prévisibles. Cela facilite aussi le réglage des limites de traitement : vous savez quelle puissance est réellement disponible.
Pour un service IA, la régularité compte autant que la puissance brute : une réponse stable inspire davantage confiance qu'un service très rapide, mais imprévisible.
Une architecture adaptée à chaque usage IA
Un serveur dédié n'est pas un produit figé. Il permet de choisir une configuration cohérente avec la nature du modèle et son cycle de vie. Une application de recherche documentaire n'a pas les mêmes besoins qu'un outil de création d'images ou qu'un agent conversationnel connecté à une base de connaissances.
Inférence en production
Pour répondre aux requêtes des utilisateurs, privilégiez une mémoire suffisante, un stockage rapide et un GPU lorsque le modèle le nécessite. La priorité est la régularité des temps de réponse.
Entraînement et expérimentation
Les essais de modèles bénéficient de cœurs de calcul disponibles, de beaucoup de RAM et d'un espace disque capable d'accueillir jeux de données, checkpoints et versions de modèles.
Traitement par lots
L'analyse nocturne de documents, d'images ou de journaux d'activité demande surtout une capacité de calcul constante et une planification fiable des tâches.
Le GPU, ou processeur graphique, accélère particulièrement les opérations parallèles courantes dans l'apprentissage profond. Il n'est pas indispensable à tous les projets : un moteur de règles, un petit modèle de classification ou certaines recherches vectorielles peuvent fonctionner correctement sur CPU. Le bon choix consiste à mesurer le besoin réel plutôt qu'à surdimensionner systématiquement l'infrastructure.
Un meilleur contrôle sur les logiciels et les données
Les projets IA reposent souvent sur un empilement logiciel précis : système d'exploitation, pilotes GPU, bibliothèques de calcul, conteneurs, serveur d'API, base vectorielle et outils de supervision. Un serveur dédié donne la liberté d'installer les versions compatibles avec votre modèle, de régler les services et de planifier les mises à jour selon vos contraintes.
Cette autonomie est utile quand un environnement doit être reproductible. Par exemple, une équipe peut figer une image de conteneur contenant une version donnée de Python, PyTorch ou TensorFlow, puis déployer la même pile sur la machine de production. Les écarts entre environnement de test et serveur final sont alors plus faciles à limiter.
Le contrôle concerne aussi les données. Certaines informations traitées par une IA - contrats, dossiers clients, conversations, fichiers médicaux ou données industrielles - ne doivent pas circuler inutilement entre plusieurs environnements. Héberger le modèle, les données et l'API au même endroit peut réduire les transferts et simplifier l'application de règles d'accès. Cela ne remplace pas les mesures de sécurité : chiffrement, comptes nominaux, droits limités, sauvegardes et journalisation restent nécessaires.
Des performances plus prévisibles pour les utilisateurs
Une application IA peut sembler parfaitement fonctionnelle lors des tests, puis ralentir dès que plusieurs personnes l'utilisent au même moment. Les modèles génératifs, notamment, traitent des requêtes longues et peuvent garder une importante quantité de données en mémoire. La capacité à absorber des pics dépend autant du matériel que de la façon dont les requêtes sont organisées.
Sur un serveur dédié, vous pouvez réserver une partie des ressources à l'API, isoler les tâches d'entraînement, limiter le nombre de requêtes simultanées ou mettre en place une file d'attente. Cette organisation évite qu'un traitement lourd bloque un assistant conversationnel déjà ouvert aux utilisateurs.
| Situation | Risque fréquent | Réponse sur serveur dédié |
|---|---|---|
| Plusieurs requêtes simultanées | Latence élevée ou erreurs mémoire | Limiter la concurrence et répartir les processus |
| Import massif de documents | API ralentie pendant l'indexation | Planifier l'indexation dans une file séparée |
| Mise à jour d'un modèle | Interruption du service | Tester une nouvelle instance avant bascule |
| Pic d'activité ponctuel | Temps de réponse instables | Surveiller les ressources et prévoir une capacité adaptée |
La performance perçue ne se limite pas au temps de calcul. Une interface qui indique l'avancement d'une requête longue, gère clairement les erreurs et ne perd pas le contexte utilisateur donne un résultat plus fiable, même lorsque le modèle a besoin de quelques instants pour répondre.
Une sécurité mieux adaptée aux projets sensibles
Un serveur dédié ne rend pas un projet sécurisé par nature, mais il facilite une séparation nette des responsabilités. Vous contrôlez les comptes d'administration, les pare-feu, les ports exposés, les clés d'accès et les flux entre composants. C'est particulièrement utile lorsqu'une API d'IA est reliée à un outil interne, à une base clients ou à des fichiers non publics.
Une configuration prudente commence par réduire la surface d'exposition : désactiver les services inutiles, n'ouvrir que les ports nécessaires, imposer des clés SSH, protéger les interfaces d'administration et isoler les services dans des conteneurs ou des réseaux distincts. Les sauvegardes doivent être testées ; une copie inutilisable au moment d'un incident ne protège rien.
Pour les modèles accessibles au public, surveillez également les usages inhabituels : volume de requêtes, erreurs répétées, tentatives d'instructions malveillantes ou consommation anormale de ressources. Ces signaux ne remplacent pas une analyse humaine, mais ils permettent d'agir avant qu'un simple abus ne devienne une indisponibilité complète.
Quand le serveur dédié devient particulièrement pertinent ?
Le serveur dédié prend tout son sens quand la charge est continue, que les données nécessitent un contrôle accru ou qu'un projet dépend de réglages matériels et logiciels précis. Il convient moins à une idée encore très incertaine, à un prototype ponctuel ou à une utilisation rare : dans ces cas, une solution à la demande peut être plus souple pour démarrer.
- Vous servez un modèle à des utilisateurs, clients ou collaborateurs de façon régulière.
- Vous avez besoin d'installer des pilotes, bibliothèques ou services spécifiques.
- Les données traitées ne doivent pas être dispersées entre de nombreux environnements.
- Votre équipe veut suivre précisément l'usage CPU, RAM, GPU, disque et réseau.
- Les temps de réponse doivent rester cohérents pendant les périodes chargées.
Le coût doit être évalué sur l'ensemble du fonctionnement, pas uniquement sur le prix de la machine. Prenez en compte l'administration, la supervision, les sauvegardes, le stockage des données, la consommation réseau et le temps consacré aux incidents. Une configuration trop faible coûte parfois plus cher en temps perdu qu'un matériel correctement dimensionné dès le départ.
Préparer le déploiement avec une méthode simple
Avant de choisir une machine, décrivez le chemin parcouru par une requête : arrivée de l'utilisateur, authentification, préparation des données, appel au modèle, stockage éventuel et réponse. Cette cartographie met souvent en lumière le vrai goulot d'étranglement. Il peut s'agir du chargement du modèle, de la lecture de fichiers, de la base de données ou du réseau, pas forcément du processeur.
- Mesurez un cas réel : utilisez quelques requêtes représentatives, avec leur taille habituelle et leur niveau de concurrence.
- Dimensionnez les ressources : estimez la mémoire nécessaire au modèle, aux données et au système, puis prévoyez une marge raisonnable.
- Isolez les rôles : séparez autant que possible l'API publique, les traitements lourds et les tâches de maintenance.
- Surveillez dès le début : suivez l'usage du CPU, de la RAM, du GPU, du stockage et les erreurs applicatives.
- Préparez le retour arrière : gardez une version stable du modèle et de la configuration pour restaurer rapidement le service.
Un projet IA bien hébergé n'est pas seulement une affaire de puissance. C'est aussi une question de discipline opérationnelle : documenter les accès, versionner les configurations, vérifier les sauvegardes et tester les changements avant de les exposer aux utilisateurs. Sur un serveur dédié, cette rigueur transforme une machine performante en base de travail durable. [ Voir ici aussi ]
La meilleure infrastructure est celle qui laisse votre équipe concentrer son attention sur le modèle et ses utilisateurs, plutôt que sur des ralentissements imprévisibles. Une machine dédiée, bien configurée et suivie dans le temps, offre ce cadre : elle permet d'expérimenter, de sécuriser les flux et de faire évoluer un projet IA sans perdre la maîtrise de ce qui se passe sous le capot.
Questions fréquentes
Un serveur dédié est-il obligatoire pour lancer un projet IA ?
Non. Un prototype, un test ponctuel ou une faible charge peuvent fonctionner sur une solution plus souple. Le serveur dédié devient intéressant lorsque l'usage est régulier, que les ressources doivent être stables ou que l'environnement logiciel exige une configuration précise.
Faut-il forcément un GPU pour une application d'IA ?
Non. Un GPU est particulièrement utile pour l'apprentissage profond, la génération d'images, de vidéo ou l'inférence de modèles volumineux. Des tâches comme l'automatisation, certains classements de texte ou des modèles légers peuvent fonctionner efficacement sur CPU.
Comment choisir la mémoire vive d'un serveur pour l'IA ?
La mémoire vive doit couvrir le système, les services, le modèle chargé et les données traitées en même temps. Testez un cas d'usage réel, observez la consommation maximale et gardez une marge pour éviter que le système ne bascule sur le disque, ce qui ralentit fortement les traitements.
Comment sécuriser une API IA hébergée sur un serveur dédié ?
Protégez l'API avec une authentification, limitez les droits des comptes, fermez les ports inutiles, conservez les secrets hors du code et surveillez les journaux. Des sauvegardes testées et des mises à jour régulières complètent cette protection.





A propos de nous : Cladwys Rackster

Passionné par l’infrastructure numérique, je partage mon expertise sur les serveurs dédiés depuis plusieurs années. J’aime rendre les concepts techniques accessibles à tous, en proposant des conseils pratiques et des analyses détaillées. Mon objectif est d’aider chacun à choisir, configurer et optimiser son serveur dédié, quel que soit son niveau. À travers mes articles, je souhaite démystifier les aspects complexes de l’hébergement et encourager l’autonomie des utilisateurs. Rejoignez-moi pour découvrir ensemble les coulisses du monde des serveurs dédiés !