Serveur dédié : les bonnes pratiques pour allier sécurité, performance et continuité d’activité
- Le serveur dédié, un choix qui exige un véritable pilotage
- La sécurité commence par une configuration maîtrisée
- Superviser les services, pas seulement l'état de la machine
- Faire de la restauration le cœur de la stratégie de sauvegarde
- Optimiser la performance sans fragiliser la production
- Évaluer une prestation d'exploitation sur des engagements concrets
- Une feuille de route de 90 jours pour reprendre le contrôle
- Une infrastructure fiable devient un avantage pour l'entreprise
Un serveur dédié offre de la liberté technique, mais sa valeur dépend surtout de la qualité de son exploitation au quotidien.
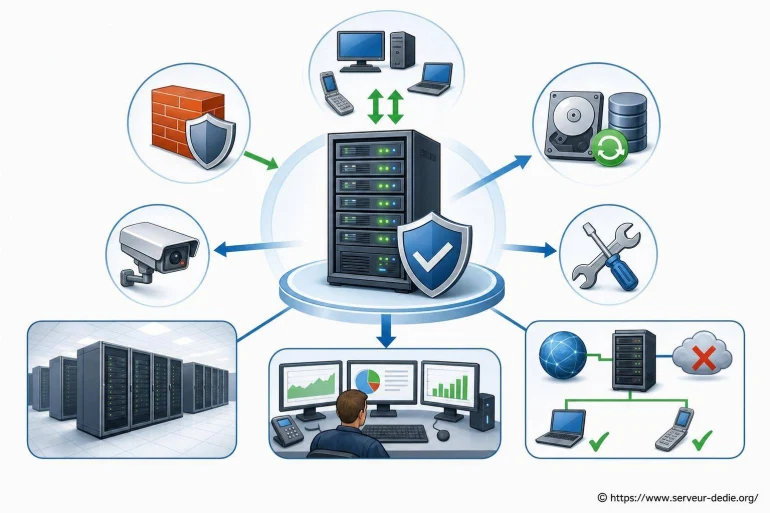
Lorsqu'un site marchand, un logiciel métier ou une plateforme de services devient essentiel à l'activité, la question n'est plus seulement de disposer d'une machine puissante. Il faut pouvoir la maintenir disponible, protéger les données et réagir sans improvisation. Une démarche d'infogérance serveur dédié permet précisément de structurer ces responsabilités : maintenance du système, supervision, sauvegardes, sécurisation et traitement des incidents. Avant d'externaliser ou d'internaliser ces tâches, il est utile de comprendre ce qui rend réellement une infrastructure fiable.
Le serveur dédié, un choix qui exige un véritable pilotage
Contrairement à un hébergement mutualisé, le serveur dédié réserve les ressources d'une machine physique à un seul client. Cette isolation peut améliorer la prévisibilité des performances et donner une grande latitude sur les logiciels installés, les réglages système et les politiques de sécurité. Elle ne dispense toutefois ni de l'administration ni de l'anticipation des risques.
Un disque qui arrive à saturation, un certificat expiré, une mise à jour incompatible ou un processus applicatif bloqué suffisent à dégrader un service pourtant hébergé sur un équipement performant. Le principal enjeu consiste donc à passer d'une gestion réactive, centrée sur la résolution des pannes, à une exploitation organisée autour de la prévention, de la mesure et de la traçabilité.
Clarifier les responsabilités dès le départ
Le périmètre d'intervention doit distinguer l'hébergeur, chargé selon le contrat de l'infrastructure physique et de la connectivité, de l'administrateur système, responsable du système d'exploitation et des services, et de l'équipe applicative, qui maîtrise le code et les déploiements. Sans cette répartition, une alerte peut circuler entre plusieurs interlocuteurs alors que le service reste indisponible.
La sécurité commence par une configuration maîtrisée
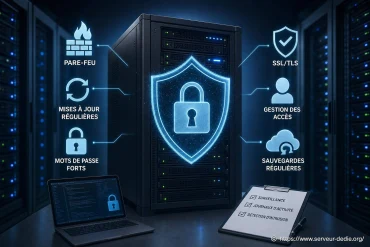
Un serveur exposé à Internet doit être traité comme un environnement de production sensible. La première étape consiste à réduire sa surface d'attaque : désinstaller les composants inutilisés, fermer les ports non indispensables et limiter les services accessibles publiquement. Le pare-feu ne remplace pas un durcissement du système, mais constitue un premier filtre utile lorsqu'il s'appuie sur des règles documentées.
Sécuriser les accès et les mises à jour
Les accès d'administration méritent une attention particulière. L'authentification forte, les comptes nominatifs, la connexion par clés lorsque cela est adapté et l'application du principe du moindre privilège réduisent les risques de compromission. Les opérations sensibles doivent pouvoir être attribuées à une personne ou à un compte technique clairement identifié.
Le maintien en condition de sécurité repose également sur un inventaire précis des versions utilisées : système Linux, serveur web, moteur de base de données, bibliothèques et outils de déploiement. Les correctifs critiques doivent être évalués et appliqués rapidement, tandis que les mises à jour majeures gagnent à être testées en préproduction pour limiter les régressions. Documenter la procédure de retour arrière est tout aussi important que planifier l'intervention.
Séparer les environnements et protéger les secrets
Lorsque plusieurs applications cohabitent, leur isolation évite qu'une défaillance locale ne se propage. Les secrets d'accès, certificats, clés API et paramètres sensibles ne doivent pas être conservés dans des dépôts de code ouverts. Une gestion centralisée des secrets et une rotation adaptée des identifiants renforcent la maîtrise des accès, notamment lorsque plusieurs prestataires interviennent sur le même serveur.
Superviser les services, pas seulement l'état de la machine
Un serveur peut répondre au ping tout en affichant une application inutilisable. Une supervision pertinente combine donc des métriques d'infrastructure, comme la charge processeur, l'utilisation de la mémoire, l'espace disque et la latence réseau, avec des contrôles orientés utilisateur : disponibilité d'une page, réponse d'une API, connexion à la base de données ou temps d'exécution d'un parcours critique.
La qualité du dispositif dépend aussi de sa capacité à distinguer une anomalie passagère d'un véritable incident. Des seuils trop sensibles provoquent une avalanche d'alertes ; des seuils trop permissifs laissent dériver les performances. Il est préférable de définir des niveaux de gravité, des horaires d'escalade et une procédure de qualification. Les journaux applicatifs et système doivent être centralisés avec des règles de conservation compatibles avec les besoins opérationnels et réglementaires.
Mesurer des indicateurs réellement exploitables
Le taux de disponibilité, le temps de détection et le délai moyen de rétablissement sont plus utiles lorsqu'ils servent à décider d'actions concrètes. L'analyse des incidents récurrents révèle parfois une cause structurelle : capacité insuffisante, configuration fragile, déploiement mal préparé ou dépendance externe non surveillée. Un tableau de bord lisible doit conduire à des arbitrages, pas simplement accumuler des graphiques.
Faire de la restauration le cœur de la stratégie de sauvegarde
Une sauvegarde réussie n'est pas seulement une tâche planifiée qui s'affiche en vert. C'est une copie exploitable, intègre et restaurable dans le délai attendu par l'entreprise. Il faut d'abord classer les données selon leur criticité : commandes, comptes clients, documents, bases de données, fichiers de configuration et secrets nécessaires au redémarrage. Cette cartographie détermine la fréquence de protection et l'ordre de restauration.
Deux indicateurs clarifient les attentes. Le RPO représente la quantité maximale de données que l'on accepte de perdre, exprimée en durée. Le RTO correspond au temps maximal visé pour remettre le service à disposition. Un outil de réservation ne présente pas les mêmes exigences qu'un site vitrine. Ces objectifs doivent être négociés avec les métiers avant de choisir les outils de sauvegarde.
Une stratégie inspirée du principe 3-2-1, avec plusieurs copies, des supports distincts et au moins une copie isolée ou hors ligne, limite les conséquences d'un incident majeur. Les sauvegardes doivent en outre être protégées par des droits restreints et testées régulièrement sur un environnement contrôlé. La restauration complète d'une application, base de données et configuration comprises, reste le test le plus convaincant.
Optimiser la performance sans fragiliser la production
Les problèmes de lenteur ne se résolvent pas toujours en ajoutant de la mémoire ou des cœurs CPU. L'analyse doit identifier le maillon limitant : requêtes SQL coûteuses, stockage saturé en entrées-sorties, cache absent, connexion réseau instable ou application qui multiplie les appels externes. Mesurer le temps de réponse à plusieurs niveaux évite des investissements inutiles.
Anticiper les pics de trafic et la croissance
Un suivi des tendances aide à prévoir l'évolution des ressources sur plusieurs mois. Avant une campagne commerciale ou une forte montée en charge, les tests de capacité peuvent valider le comportement des applications et des bases de données. Selon l'architecture, la réponse peut combiner cache, optimisation logicielle, stockage plus rapide, répartition de charge ou évolution vers plusieurs machines. Le serveur dédié n'est pas nécessairement une fin en soi : il doit s'inscrire dans une trajectoire technique cohérente.
Les changements en production exigent également une discipline de déploiement. Versions identifiées, fenêtre d'intervention adaptée, sauvegarde vérifiée, contrôle après mise en ligne et scénario de retour arrière limitent les interruptions évitables. Un historique des modifications accélère le diagnostic lorsqu'un incident apparaît après une intervention.
Évaluer une prestation d'exploitation sur des engagements concrets
Lorsqu'une entreprise confie son serveur à un prestataire, le prix mensuel ne suffit pas à comparer les offres. Le contrat doit préciser les systèmes couverts, la supervision des applications, les mises à jour, la gestion des sauvegardes, les interventions de sécurité et les exclusions. Il est essentiel de distinguer la présence d'une équipe, le délai de prise en charge d'une alerte et le délai de rétablissement réellement visé.
Un accord de niveau de service utile décrit des engagements mesurables et des procédures d'escalade. Il indique également qui valide les changements, comment sont annoncées les opérations planifiées et quels comptes rendus sont fournis. La réversibilité mérite d'être traitée dès la signature : documentation, accès, sauvegardes, inventaire technique et modalités de transfert ne doivent pas dépendre d'un seul interlocuteur.
Une feuille de route de 90 jours pour reprendre le contrôle
Une organisation peut progresser sans revoir toute son infrastructure immédiatement. Une démarche graduelle permet d'obtenir rapidement de la visibilité, puis de sécuriser et de stabiliser les pratiques d'exploitation.
- Jours 1 à 30 : inventorier les actifs, les accès, les dépendances, les versions et les risques ; vérifier les sauvegardes existantes et désigner les responsables de chaque composant.
- Jours 31 à 60 : corriger les expositions prioritaires, activer une supervision de bout en bout, formaliser les procédures d'alerte et réaliser un premier test de restauration.
- Jours 61 à 90 : ajuster les seuils, analyser les capacités, tester les scénarios d'incident, documenter les changements et définir un rendez-vous périodique de pilotage.
Cette feuille de route doit rester proportionnée à l'activité. Une PME exploitant une seule application critique n'a pas besoin de reproduire l'organisation d'un grand groupe, mais elle doit savoir qui intervient, avec quels accès, sur la base de quelles informations et dans quel ordre de priorité.
Une infrastructure fiable devient un avantage pour l'entreprise
Un serveur dédié bien administré se remarque rarement : les utilisateurs accèdent à leurs services, les équipes déploient avec confiance et les responsables disposent d'une visibilité claire sur les risques. Cette stabilité résulte d'un ensemble de pratiques complémentaires, depuis la sécurisation des accès jusqu'aux tests de restauration, en passant par la supervision et la gestion des changements.
L'enjeu n'est donc pas d'accumuler les outils, mais de créer une chaîne de responsabilités lisible et vérifiable. Avec des objectifs adaptés aux usages, des contrôles réguliers et une capacité d'intervention éprouvée, l'infrastructure cesse d'être un point d'incertitude et devient un véritable support de la continuité d'activité. [ Voir ici aussi ]
👉 Lire aussi: Test de Infomaniak et Test de PlanetHoster





A propos de nous : Cladwys Rackster

Passionné par l’infrastructure numérique, je partage mon expertise sur les serveurs dédiés depuis plusieurs années. J’aime rendre les concepts techniques accessibles à tous, en proposant des conseils pratiques et des analyses détaillées. Mon objectif est d’aider chacun à choisir, configurer et optimiser son serveur dédié, quel que soit son niveau. À travers mes articles, je souhaite démystifier les aspects complexes de l’hébergement et encourager l’autonomie des utilisateurs. Rejoignez-moi pour découvrir ensemble les coulisses du monde des serveurs dédiés !